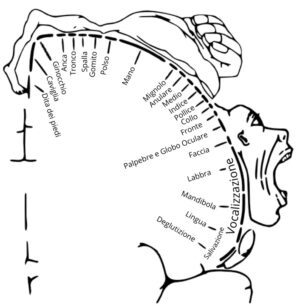
Nel primo stadio del sistema visivo dei primati, come in V1, gli oggetti sono codificati in termini di coordinate retinotopiche, e lesioni di quest’area causano difetti nello spazio visivo che mantengono una costante localizzazione retinica.
Nei livelli successivi, in corrispondenza di IT (area inferotemporale), i campi recettivi sono indipendenti dalla localizzazione retinica e i neuroni possono essere attivati da uno stimolo specifico come una faccia. I difetti causati da lesioni IT sono basate sulle proprietà dell’oggetto e indipendenti dalla localizzazione retinica. Nel momento in cui le coordinate spostano il loro centro sull’oggetto, il sistema diviene indipendente dalla precisa metrica dell’oggetto, questo significa che il sistema continua a rispondere all’oggetto, nonostante le variazioni di grandezza, orientamento e tessitura.
Studi sul macaco suggeriscono che per l’analisi delle facce queste trasformazioni avvengono nell’area IT anteriore, mentre la risposta delle cellule, nel solco temporale superiore (STS) è selettiva per l’angolo di presentazione dell’oggetto e la loro informazione in uscita potrebbe essere combinata in IT per produrre una cellula indipendente all’angolo di visualizzazione. Ne consegue che danni selettivi ad IT causano l’incapacità di riconoscere un oggetto che va sotto il nome di agnosia visiva.
indice
Perché le cose appaiono come appaiono?
Questa domanda fondamentale ha affascinato filosofi e scienziati per secoli. Due delle risposte più comuni provengono dal realismo ingenuo e dal realismo critico.
Il realismo ingenuo: una visione diretta della realtà
Il realista ingenuo sostiene che ciò che percepiamo è una copia fedele della realtà esterna. In altre parole, le cose appaiono come appaiono perché sono esattamente così. Non c’è alcuna mediazione o interpretazione da parte della nostra mente.
- Esempi:
- Se vedo un tavolo di legno, è perché c’è effettivamente un tavolo di legno di fronte a me.
- Se sento un suono forte, è perché c’è una fonte sonora che produce quel rumore.
Limiti del realismo ingenuo:
- Illusioni ottiche: Come spiegare le illusioni ottiche, in cui percepiamo qualcosa di diverso dalla realtà fisica?
- Relatività della percezione: La percezione varia da persona a persona e può essere influenzata da fattori come l’esperienza, le aspettative e lo stato emotivo.

Quante zampe ha l’elefante?
Il realismo critico: la costruzione attiva della percezione
Il realista critico offre una visione più complessa della percezione. Secondo questa prospettiva, la percezione non è una semplice registrazione passiva della realtà, ma una costruzione attiva alla quale contribuiscono sia l’ambiente fisico che il sistema percettivo.
- L’ambiente fisico (stimoli): Gli stimoli che provengono dal mondo esterno forniscono le informazioni di base per la nostra percezione. Tuttavia, questi stimoli sono spesso ambigui e incompleti.
- Il sistema percettivo: Il nostro cervello interpreta e organizza gli stimoli sensoriali, creando una rappresentazione mentale del mondo. Questo processo è influenzato da:
- Esperienze passate: Le nostre esperienze precedenti modellano il modo in cui interpretiamo gli stimoli presenti.
- Conoscenze: Le nostre conoscenze e aspettative influenzano la nostra percezione.
- Processi cognitivi: L’attenzione, la memoria e il linguaggio giocano un ruolo fondamentale nella costruzione della percezione.
- Esempi:
- L’illusione di Müller-Lyer: Due linee della stessa lunghezza appaiono di diversa lunghezza a causa delle frecce alle loro estremità.
- Il fenomeno della costanza percettiva: Riconosciamo un oggetto come lo stesso, anche se cambia la sua dimensione o l’illuminazione.
In sintesi:
Il realismo critico ci invita a considerare la percezione come un processo attivo e costruttivo, in cui il cervello utilizza le informazioni sensoriali e le conoscenze pregresse per creare una rappresentazione soggettiva del mondo. Questa visione ci aiuta a comprendere meglio le illusioni ottiche, la relatività della percezione e il ruolo della mente nella costruzione della nostra realtà
Il modello a tre stadi dell’elaborazione visiva
Il modello a tre stadi dell’elaborazione visiva è una semplificazione utile per comprendere come il nostro cervello elabora le informazioni visive che riceve dagli occhi. Questo modello suddivide il processo visivo in tre fasi principali:
1. Visione di basso livello (Low-level vision)
In questa prima fase, il cervello si occupa di analizzare le caratteristiche più semplici dell’immagine, come:
- Contorni: I bordi e le linee che definiscono gli oggetti.
- Colori: Le tonalità e le sfumature presenti nell’immagine.
- Texture: La struttura superficiale degli oggetti.
Pensa a questa fase come a un’analisi preliminare dell’immagine, un po’ come quando un detective esamina attentamente una scena del crimine alla ricerca di indizi.
2. Visione di medio livello (Middle-level vision)
Una volta estratte le caratteristiche di base, il cervello inizia a raggrupparle in unità più significative. In questa fase, entrano in gioco processi come:
- Riconoscimento di forme: Il cervello cerca di identificare forme semplici e complesse all’interno dell’immagine.
- Percezione della profondità: Grazie a indizi come la prospettiva, le ombre e la parallasse, il cervello è in grado di stimare la distanza degli oggetti.
- Segmentazione dell’immagine: Il cervello divide l’immagine in regioni distinte, corrispondenti a diversi oggetti.
È come se il detective, dopo aver raccolto gli indizi, iniziasse a mettere insieme i pezzi del puzzle per ricostruire l’accaduto.
3. Visione di alto livello (High-level vision)
Nell’ultima fase, il cervello utilizza le informazioni raccolte nelle fasi precedenti per interpretare la scena nel suo complesso. In questa fase entrano in gioco processi cognitivi più complessi come:
- Riconoscimento di oggetti: Il cervello confronta le informazioni visive con le proprie conoscenze pregresse per identificare gli oggetti presenti nell’immagine.
- Comprensione della scena: Il cervello cerca di dare un senso alla scena nel suo insieme, comprendendo le relazioni tra gli oggetti e lo scopo della scena stessa.
- Interazione con l’ambiente: Sulla base della comprensione della scena, il cervello pianifica le azioni da compiere.
È come se il detective, dopo aver risolto il caso, fosse in grado di descrivere l’intera storia e le motivazioni degli attori coinvolti.
Un’analogia:
Pensa alla visione come a un processo di costruzione di un modello mentale del mondo esterno. La visione di basso livello fornisce i mattoncini, la visione di medio livello li assembla in strutture più grandi e la visione di alto livello crea un modello coerente e significativo dell’intero edificio.
Perché questo modello è importante?
Questo modello semplificato ci aiuta a comprendere meglio come il nostro cervello elabora le informazioni visive e a sviluppare algoritmi per la visione artificiale. Inoltre, ci permette di studiare i disturbi della visione, come l’agnosia visiva, che colpiscono specifiche fasi di questo processo.
Limitazioni del modello:
Va sottolineato che questo è un modello semplificato e che l’elaborazione visiva è un processo molto più complesso e dinamico. Molte delle fasi si sovrappongono e interagiscono tra loro in modo non lineare. Inoltre, il modello non tiene conto del ruolo dell’attenzione e delle conoscenze pregresse, che influenzano fortemente la percezione visiva.
Teoria di Marr
David Marr, un pioniere delle neuroscienze cognitive, propose una teoria rivoluzionaria per spiegare come il cervello elabora le informazioni visive e costruisce una rappresentazione tridimensionale del mondo che ci circonda. Basandosi sulle scoperte di Hubel e Wiesel sulla fisiologia della corteccia visiva, Marr suddivise l’analisi visiva in quattro stadi successivi, ciascuno corrispondente a un livello crescente di complessità e astrazione.
Marr sosteneva che la visione sia un processo computazionale, ovvero un insieme di calcoli che trasformano l’input visivo in una rappresentazione utile per l’organismo.
Il primo stadio, l’abbozzo primario grezzo, consiste nell’estrazione dei contorni semplici e dei bordi presenti nell’immagine. Il secondo stadio, l’abbozzo primario completo, integra queste informazioni per costruire una rappresentazione più ricca delle strutture presenti nella scena. Il terzo stadio, l’abbozzo 2 ½ dimensionale, aggiunge informazioni sulla profondità e sul movimento, creando una rappresentazione centrata sull’osservatore. Infine, il quarto stadio, il modello tridimensionale, produce una rappresentazione centrata sull’oggetto, indipendente dal punto di vista dell’osservatore.
Livelli di rappresentazione visiva secondo la teoria di Marr
| Livello | Descrizione | Descrizione Immagine |
|---|---|---|
| 1. Abbozzo Primario Grezzo | Descrizione dei bordi e contorni semplici, inclusi la loro localizzazione e orientamento. | Casa vista frontalmente con contorni semplici di muri, finestre e porta. |
| 2. Abbozzo Primario Completo | Rappresentazione di strutture più grandi come confini e regioni. | Stessa casa della figura precedente, ma con definizione più chiara delle facciate, del tetto e delle divisioni interne. |
| 3. Abbozzo 2 ½ Dimensionale | Rappresentazione più completa di oggetti su rappresentazioni centrate sull’osservatore, ottenuta tramite l’analisi della profondità, del movimento e delle strutture assemblate nell’abbozzo primario. | Stessa casa, ma con l’aggiunta di elementi che suggeriscono la profondità, come l’ombra proiettata dal tetto e la rappresentazione parziale di un cerchio che indica un volume. |
| 4. Modello Tridimensionale | Rappresentazione centrata sull’oggetto piuttosto che sull’osservatore. | Rappresentazione di oggetti isolati (casa, automobile, pupazzo di neve) con indicazioni delle loro forme tridimensionali e delle loro relazioni spaziali. |
La teoria di Marr ha avuto un impatto profondo sulla ricerca in ambito visivo, sia nelle neuroscienze che nell’intelligenza artificiale. Tuttavia, presenta anche dei limiti e ha suscitato numerose critiche. Nonostante ciò, il suo approccio computazionale alla visione continua a ispirare nuove generazioni di ricercatori e a guidare lo sviluppo di sistemi di visione artificiale sempre più sofisticati
Primo stadio dell’elaborazione visiva: “Low-level vision”
Il primo stadio dell’elaborazione visiva, la “low-level vision” o visione di basso livello, è fondamentale per la nostra percezione del mondo. È qui che l’occhio cattura la luce riflessa dagli oggetti e il cervello inizia a decodificare le informazioni visive in una rappresentazione comprensibile.
Elaborazione nella low-level vision
- Rilevamento dei contorni: Il sistema visivo individua i cambiamenti di luminosità e di colore nell’immagine, che corrispondono ai bordi e ai contorni degli oggetti.
- Estrazione delle caratteristiche: Vengono estratte altre caratteristiche fondamentali come la texture, l’orientamento delle linee e la frequenza spaziale.
- Segmentazione: L’immagine viene suddivisa in regioni omogenee, corrispondenti a diversi oggetti o parti di oggetti.
Meccanismi neurali coinvolti
Quesi processi sono realizzati grazie a una complessa rete di neuroni specializzati nella corteccia visiva primaria. Questi neuroni sono sensibili a specifiche caratteristiche visive, come linee orientate in una particolare direzione o punti di luce in movimento.
Importanza della low-level vision
La low-level vision è la base per tutti i successivi stadi di elaborazione visiva. Senza una corretta analisi delle caratteristiche di base dell’immagine, sarebbe impossibile riconoscere gli oggetti, percepire la profondità o comprendere le scene complesse
Rilevare i bordi nel triangolo di Kanizsa: una sfida per i computer
In questa illusione, percepiamo un triangolo bianco anche se non ci sono linee che lo definiscono esplicitamente. I bordi del triangolo sono, in realtà, il prodotto di un’inferenza visiva del nostro cervello, basata su indizi come la chiusura, la convessità e la simmetria degli elementi presenti nell’immagine.

Perché è così difficile da rilevare?
- Assenza di evidenza fisica: A differenza di un triangolo disegnato con linee nette, nel triangolo di Kanizsa i bordi non sono esplicitamente definiti. Sono il risultato di un’inferenza visiva, di un “completamento” che il nostro cervello opera in base a indizi come la chiusura, la convessità e la simmetria.
- La magia della Gestalt: La nostra percezione è guidata da principi di organizzazione percettiva (Gestalt) che ci portano a vedere delle forme complete anche quando gli elementi sono incompleti o frammentati. Questi principi, così intuitivi per noi umani, sono molto difficili da formalizzare e implementare in un algoritmo.
- Il contesto è importante: Il contesto visivo è fondamentale per la percezione del triangolo di Kanizsa. Le pareti di Kanizsa e le forme incomplete creano un contesto che orienta la nostra percezione verso la costruzione di un triangolo.
Il secondo stadio dell’elaborazione visiva: “Middle vision”
Dopo aver estratto le caratteristiche di base di un’immagine (contorni, texture, colori) durante la “low-level vision”, il sistema visivo passa alla fase successiva: la “middle vision”. È qui che le diverse caratteristiche vengono integrate e organizzate per formare delle percezioni coerenti e significative.
Cosa succede nella middle vision?
- Raggruppamento percettivo: Le caratteristiche visive vengono raggruppate secondo principi di organizzazione percettiva (Gestalt) come:
- Similitudine: Elementi simili (per colore, forma, dimensione) tendono ad essere raggruppati insieme.
- Vicinanza: Elementi vicini nello spazio tendono ad essere percepiti come appartenenti allo stesso oggetto.
- Buona continuazione: Le linee tendono ad essere percepite come continue, anche se sono parzialmente occluse.
- Chiusura: Le forme incomplete tendono ad essere percepite come complete.
- Simmetria: Gli elementi simmetrici tendono ad essere raggruppati insieme.
- Segmentazione: L’immagine viene suddivisa in regioni corrispondenti a diversi oggetti o parti di oggetti.
- Articolazione figura-sfondo: Viene determinato quali parti dell’immagine corrispondono alla figura e quali allo sfondo.

L’illusione di Rubin ci mostra come il nostro cervello organizza attivamente le informazioni visive, alternando la percezione tra un vaso e due profili umani. Questo fenomeno, noto come figura-sfondo, è un classico esempio di come la nostra percezione possa essere ambigua e dipendere dal contesto.
La middle vision è fondamentale per la nostra capacità di riconoscere gli oggetti e di interpretare le scene visive. Grazie a questo stadio, siamo in grado di:
- Identificare gli oggetti: Anche se un oggetto è parzialmente occluso o deformato, siamo in grado di riconoscerlo grazie alle sue caratteristiche distintive.
- Percepire la profondità: La middle vision ci permette di organizzare gli elementi visivi in profondità, creando la percezione di un mondo tridimensionale.
- Interpretare le scene: Siamo in grado di comprendere il significato di una scena visiva, identificando gli oggetti presenti, le loro relazioni spaziali e le loro funzioni.
Teorie della gestalt
La psicologia della Gestalt, con il suo principio fondamentale secondo cui “il tutto è più della somma delle parti“, ha offerto contributi significativi alla comprensione della percezione visiva. I gestaltisti hanno postulato che il nostro sistema visivo, anziché limitarsi a registrare passivamente le informazioni sensoriali, tende attivamente a organizzarle in configurazioni significative e coerenti.
Il riconoscimento visivo, in questa prospettiva, può essere inteso come il processo attraverso cui il cervello confronta l’immagine retinica di un oggetto con rappresentazioni mentali preesistenti, immagazzinate in memoria. Questa corrispondenza permette di identificare l’oggetto indipendentemente dalla sua posizione nello spazio o dall’angolazione da cui lo osserviamo.
Il primo stadio di questo processo avviene nella corteccia visiva primaria (V1). Qui, le informazioni visive provenienti dalla retina vengono scomposte in elementi semplici come linee, bordi e contorni. È proprio a partire da queste unità elementari che il cervello inizia a costruire rappresentazioni più complesse e significative del mondo visivo.
I principi che guidano il sistema visivo nella costruzione di bordi e dei contorni per formare gli oggetti possono essere ritrovati nel pensiero della Gestalt sulla visione che propone una serie di regole per la definizione dei contorni.
Principi della Gestalt
| Principio | Definizione dei contorni |
|---|---|
| Pregnanza | Ogni configurazione di stimoli è percepita in modo tale che la struttura risultante sia la più semplice possibile. |
| Prossimità | Tendenza degli oggetti vicini ad essere raggruppati insieme in una unità percettiva. |
| Similarità | Se diversi stimoli sono presentati insieme, c’è una tendenza a percepire la forma in modo che gli stimoli simili siano raggruppati insieme. |
| Chiusura | Tendenza ad unire i bordi che sono molto vicini l’uno all’altro. |
| Buona continuità | Gli elementi vicini sono raggruppati insieme quando sono potenzialmente connessi da una linea continua dritta o curva. |
| Destino comune | Gli elementi che si muovono nella stessa direzione sembrano essere raggruppati insieme. |
| Familiarità | Gli elementi hanno una maggiore probabilità di raggrupparsi se i gruppi appaiono familiari o hanno un significato. |
|
Alcuni principi della Gestalt | |
 |  |
| Legge della chiusura.Tendenza a percepire come uniti bordi che sono molto vicini tra loro | Legge della vicinanza.Tendenza a percepire oggetti raggruppati come una singola unità percettiva. |
 |  |
| Legge della somiglianza:Tendenza a percepire una forma quando più stimoli sono presentati contemporaneamente. | Principio di buona continuità. Il contorno illusorio è definito dallo sfasamento delle linee di due reticoli. |
Per esempio, secondo il principio di buona continuità, un bordo è percepito come continuo se gli elementi di cui è composto possono essere congiunti da una linea curva o dritta, originando così le illusioni. Gli psicologi hanno ipotizzato che i contorni definiti dalla buona continuità fossero costruiti a livello centrale ma recenti risultati suggeriscono che i contorni illusori siano estratti a un livello precoce del sistema visivo.
Studi fisiologici hanno mostrato che specifiche popolazioni di cellule, nelle prime aree visive (V1 e V2), rispondono selettivamente all’orientamento dei contorni definiti dalla buona continuità. Inoltre, circa un terzo delle cellule misurate in V2 rispondono bene a contorni illusori che si estendono attraverso interruzioni, tanto quanto a normali contorni di luminanza e mostrano un’equivalente selettività per l’orientamento dei bordi sia reali sia illusori.
Questa immagine dimostra la straordinaria capacità del nostro cervello di interpretare l’informazione visiva. Nonostante l’ordine casuale delle lettere all’interno delle parole, siamo in grado di leggere la frase grazie alla nostra capacità di riconoscere le parole in base alla loro forma complessiva. Questo fenomeno è un esempio di come il nostro cervello utilizza indizi contestuali e pattern per costruire un’interpretazione coerente del mondo

Il terzo stadio dell’elaborazione visiva: “High-level vision”
La visione di alto livello è lo stadio finale dell’elaborazione visiva, dove le informazioni grezze raccolte dagli occhi vengono trasformate in rappresentazioni mentali significative del mondo. In questa fase, il nostro cervello va oltre la semplice percezione di forme e colori, per attribuire un significato agli oggetti che vediamo, riconoscerli e categorizzarli.
Cosa succede nella visione di alto livello?
- Riconoscimento di oggetti: Il sistema visivo confronta le rappresentazioni degli oggetti estratte dalla scena con le rappresentazioni immagazzinate in memoria. Questo processo ci permette di identificare oggetti familiari e di distinguerli da altri.
- Categorizzazione: Gli oggetti vengono assegnati a categorie semantiche (es. animale, veicolo, cibo) sulla base delle loro caratteristiche visive e delle nostre conoscenze sul mondo.
- Interpretazione delle scene: Il cervello integra le informazioni provenienti da diverse parti dell’immagine per costruire una rappresentazione coerente della scena complessiva. Questo include la comprensione delle relazioni spaziali tra gli oggetti, la percezione della profondità e la stima delle dimensioni.
- Attribuzione di significato: Gli oggetti vengono collocati in un contesto più ampio e viene attribuito loro un significato in base alle nostre esperienze e conoscenze.
Come funziona il riconoscimento degli oggetti?
Ci sono diverse teorie sul riconoscimento degli oggetti, ma una delle più influenti è la teoria dei prototipi. Secondo questa teoria, ogni categoria ha un prototipo, ovvero un esempio ideale che rappresenta al meglio quella categoria. Quando vediamo un nuovo oggetto, lo confrontiamo con i prototipi immagazzinati in memoria e lo assegniamo alla categoria più simile.
Quali sono le sfide della visione di alto livello?
- Variabilità degli oggetti: Gli oggetti possono presentarsi in diverse pose, dimensioni e condizioni di illuminazione, rendendo difficile il riconoscimento.
- Occlusioni: Gli oggetti possono essere parzialmente o completamente occlusi da altri oggetti, complicando il processo di riconoscimento.
- Ambiguità: A volte, le informazioni visive sono ambigue e possono dare luogo a più interpretazioni possibili.
In conclusione, la visione di alto livello è un processo cognitivo complesso che ci permette di interpretare il mondo visivo e di interagire con esso in modo significativo. Comprendere i meccanismi alla base di questo processo è fondamentale per lo sviluppo di tecnologie sempre più avanzate e per una migliore comprensione del funzionamento del nostro cervello.
Il riconoscimento degli oggetti in 3D
Una volta che il cervello ha costruito una rappresentazione tridimensionale della scena, può iniziare a riconoscere gli oggetti. Il riconoscimento di oggetti in 3D è un processo complesso che coinvolge una combinazione di fattori.
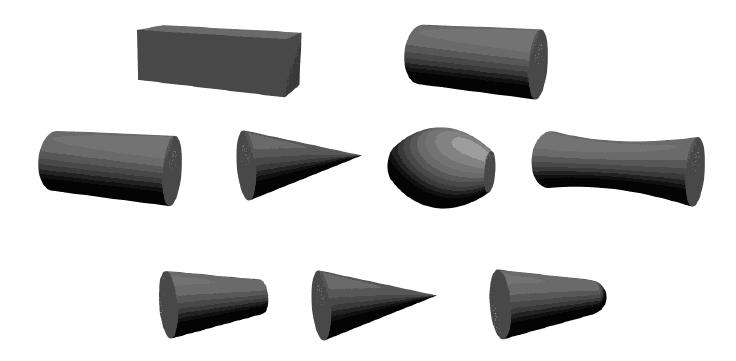
La teoria dei geoni proposta da Irving Biederman offre una spiegazione affascinante su come il cervello scompone gli oggetti in forme geometriche semplici, chiamate geoni. Questi geoni, come cilindri, cubi o coni, sono come i mattoncini con cui il nostro cervello costruisce le rappresentazioni mentali degli oggetti.
- Le caratteristiche invarianti: I geoni sono caratterizzati da proprietà invarianti alla vista, come l’asse di simmetria, la curvatura e la presenza di spigoli. Queste caratteristiche rimangono costanti anche quando l’oggetto viene ruotato o parzialmente occluso, rendendo i geoni ideali per il riconoscimento degli oggetti in diverse condizioni.
- I modelli mentali: Il cervello confronta i geoni estratti dalla scena con i modelli mentali di geoni immagazzinati in memoria. Quando trova una corrispondenza tra i geoni della scena e quelli dei modelli mentali, riconosce l’oggetto.
- Il contesto: Il contesto in cui l’oggetto si trova continua a giocare un ruolo fondamentale, aiutando il cervello a disambiguare le possibili interpretazioni e a scegliere il modello mentale più appropriato.
Le sfide del riconoscimento 3D
Nonostante i le spiegazioni offerte dalla teoria dei geoni, il riconoscimento di oggetti in 3D rimane una sfida complessa. Le variazioni di illuminazione, le occlusioni parziali e le deformazioni degli oggetti possono rendere difficile l’estrazione dei geoni e il loro successivo riconoscimento. Inoltre, il nostro cervello può essere ingannato da illusioni ottiche che sfruttano le nostre conoscenze sulla percezione della profondità e sulla struttura degli oggetti.
Come Mettere Insieme il Tutto: Il Modello Pandemonium di Selfridge
Il Modello Pandemonium: Un’Architettura Mentale
Oliver Selfridge, nel 1959, propose un modello innovativo per spiegare come il cervello riconosce le lettere, il modello Pandemonium. Questo modello, pur essendo stato concepito in un’epoca in cui le conoscenze sulle neuroscienze erano limitate, offre ancora oggi una base solida per comprendere i processi cognitivi alla base del riconoscimento visivo.

Schema del modello di Pandemonium: un’analogia per spiegare il riconoscimento visivo. L’immagine viene scomposta in caratteristiche semplici (linee, curve) che attivano i “demoni” associati a determinate lettere. Il “demone decisionale” integra queste informazioni per identificare la lettera.
I “Demoni”: Un’Allegoria Funzionale
Il termine “pandemonio” evoca un’immagine di caos e confusione, ma nel modello di Selfridge ha un significato ben preciso. I “demoni” rappresentano, in modo metaforico, diverse unità di elaborazione dell’informazione che lavorano in parallelo per riconoscere uno stimolo. Ogni “demone” è specializzato in un compito specifico:
- Demoni dell’immagine: Ricevono lo stimolo visivo iniziale (es. una lettera) e lo scompongono in caratteristiche elementari (linee, curve, angoli).
- Demoni delle caratteristiche: Analizzano le caratteristiche elementari e le confrontano con i modelli che hanno in memoria.
- Demoni cognitivi: Ascoltano i “gridi” dei demoni delle caratteristiche e, in base alla combinazione di caratteristiche presenti, “gridano” a loro volta il nome dell’oggetto riconosciuto.
- Demone decisionale: Ascolta i “gridi” dei demoni cognitivi e decide quale oggetto è stato riconosciuto, in base al demone che “grida” più forte.
Un Parallelo con il Cervello
Sebbene i “demoni” siano una metafora, il modello Pandemonium riflette in modo sorprendentemente accurato il funzionamento del cervello. Ogni livello del modello può essere messo in relazione con diverse aree corticali:
- Demoni dell’immagine: Corrispondono alle aree visive primarie, dove lo stimolo viene scomposto nelle sue componenti elementari.
- Demoni delle caratteristiche: Corrispondono alle aree visive associative, dove le caratteristiche vengono combinate per formare rappresentazioni più complesse.
- Demoni cognitivi: Corrispondono alle aree del cervello coinvolte nella memoria e nel riconoscimento degli oggetti.
- Demone decisionale: Corrisponde alle aree frontali, coinvolte nei processi decisionali.
Il Principio del “Perception by Committee”
Il modello Pandemonium si basa sul principio del “perception by committee”, ovvero il riconoscimento di un oggetto è il risultato di un processo collaborativo tra diverse unità di elaborazione. Ogni demone contribuisce con le proprie informazioni, e il demone decisionale integra tutti questi contributi per prendere una decisione finale.
Limiti e Evoluzioni del Modello
Il modello Pandemonium ha dei limiti. Ad esempio, non spiega come si formano i modelli mentali dei demoni cognitivi, né come il cervello gestisce l’ambiguità e l’incertezza. Tuttavia, è stato un punto di partenza fondamentale per lo sviluppo di modelli più sofisticati di riconoscimento visivo, come le reti neurali artificiali.
Integrazione con Altri Modelli
Il modello Pandemonium può essere integrato con altri modelli, come la teoria dei geoni, per offrire una descrizione più completa del riconoscimento degli oggetti. Ad esempio, i geoni potrebbero rappresentare le caratteristiche elementari riconosciute dai demoni delle caratteristiche.
Conclusioni
Il modello Pandemonium, pur essendo stato proposto oltre sessant’anni fa, conserva ancora oggi la sua validità. Offre una visione semplificata ma efficace dei processi cognitivi alla base del riconoscimento visivo. La sua importanza risiede nel fatto di aver ispirato numerose ricerche successive e di aver contribuito a gettare le basi per lo sviluppo dell’intelligenza artificiale.
Come Mettere Insieme il Tutto: Il Sistema “Cosa” e il Sistema “Dove/Come” nel Riconoscimento degli Oggetti
Un’Architettura Duale per la Percezione Visiva
Quando osserviamo il mondo che ci circonda, il nostro cervello esegue un’elaborazione complessa delle informazioni visive, permettendoci di identificare gli oggetti, di localizzarli nello spazio e di pianificare le nostre azioni. Questa capacità è resa possibile da due sistemi neurali principali, che lavorano in parallelo e in stretta interazione:
- Sistema “Cosa” (What): Focalizzato sull’identità degli oggetti. Questo sistema, principalmente localizzato nella corteccia inferotemporale (IT), è responsabile del riconoscimento degli oggetti, indipendentemente dalla loro posizione, dimensione o orientamento. È grazie a questo sistema che siamo in grado di distinguere un gatto da un cane, o una tazza da un bicchiere.
- Sistema “Dove/Come” (Where/How): Focalizzato sulla localizzazione spaziale degli oggetti e sulla pianificazione delle azioni. Questo sistema, principalmente localizzato nella corteccia parietale, ci permette di determinare dove si trova un oggetto nello spazio e di pianificare i movimenti necessari per interagire con esso. È grazie a questo sistema che possiamo afferrare un oggetto o evitarne un ostacolo.
Integrazione dei due sistemi
Sebbene i due sistemi abbiano funzioni distinte, essi non operano in modo isolato. Al contrario, sono strettamente interconnessi e si scambiano informazioni in modo continuo. L’integrazione tra il sistema “Che Cosa” e il sistema “Dove/Come” è fondamentale per una percezione visiva completa e funzionale.
Integrare le aree visive: da V1 ad AIT
Comprendere la gerarchia visiva
Il cervello, attraverso una serie di aree specializzate, elabora le informazioni visive per consentirci di percepire il mondo in modo completo e dettagliato. Le aree V1, V4, PIT e AIT rappresentano tappe fondamentali in questa complessa catena di elaborazione.
Un viaggio attraverso la corteccia visiva
- V1 (Corteccia visiva primaria): È la prima area corticale a ricevere le informazioni visive dalla retina. Qui, l’immagine viene scomposta in elementi semplici come linee, bordi e colori. La sua risoluzione spaziale è molto alta, permettendoci di percepire dettagli fini.
- V4: Aumenta il campo recettivo dei neuroni, consentendo di integrare informazioni da aree più vaste di V1. È coinvolta nell’elaborazione dei colori e delle forme più complesse.
- PIT (Area Infero-temporae Posteriore): I neuroni di questa area hanno campi recettivi ancora più grandi, rispondendo a oggetti specifici indipendentemente dalla loro posizione nello spazio. È considerata una delle prime aree coinvolte nel riconoscimento degli oggetti.
- AIT (Area Infero-temporae Anteriore): L’area AIT ha i campi recettivi più grandi di tutte le aree visive. I neuroni qui rispondono a oggetti complessi e specifici, come i volti.
Come si integrano queste aree?
L’informazione visiva fluisce gerarchicamente da V1 verso le aree più anteriori. Ogni area aggiunge un livello di complessità all’elaborazione, integrando le informazioni provenienti dalle aree precedenti.
- Gerarchia di complessità: Man mano che l’informazione si propaga lungo la via visiva, le rappresentazioni diventano sempre più astratte e complesse. Da semplici caratteristiche visive in V1, si passa a rappresentazioni di oggetti interi in AIT.
- Parallelismo: L’elaborazione visiva non è solo gerarchica, ma anche parallela. Diverse caratteristiche dell’immagine (colore, forma, movimento) vengono elaborate contemporaneamente lungo vie separate, per poi convergere nelle aree associative.
- Feedback: Le connessioni neurali non sono solo feedforward (da V1 ad AIT), ma anche feedback (da AIT a V1). Questo permette alle aree più anteriori di modulare l’attività delle aree più posteriori, influenzando così l’elaborazione dell’informazione.
Il ruolo delle dimensioni dei campi recettivi
Le dimensioni dei campi recettivi aumentano progressivamente da V1 ad AIT. Questo significa che:
- V1: Cattura dettagli fini e locali dell’immagine.
- AIT: Integra informazioni da vaste porzioni dell’immagine, permettendo di riconoscere oggetti complessi e di contestualizzarli nella scena.
Il riconoscimento di un oggetto non è un evento isolato, ma il risultato di un processo complesso che coinvolge l’intera via visiva. L’informazione visiva viene elaborata a diversi livelli, da caratteristiche semplici a rappresentazioni complesse di oggetti. L’integrazione di queste informazioni, attraverso le connessioni tra le diverse aree visive, ci permette di percepire il mondo in modo ricco e dettagliato.
In sintesi
Il sistema visivo è organizzato in modo gerarchico, con aree specializzate che elaborano diversi aspetti dell’informazione visiva. L’aumento delle dimensioni dei campi recettivi e l’integrazione delle informazioni lungo la via visiva sono fondamentali per il riconoscimento degli oggetti.
Correlati neurali implicati nella percezione e nel riconoscimento degli oggetti
Le differenze di colore sono rilevate precocemente nel sistema visivo
Davis e Driver, al fine di distinguere gli stadi di analisi precoce e tardivi delle informazioni visive hanno utilizzato un compito di ricerca visiva . Per es. una singola lettera rossa è individuata istantaneamente tra molte lettere bianche mescolate (pop-out), ma l’identificazione di una L in mezzo a tante T richiede molto più tempo. Questo risultato dimostra che le differenze di colore siano rilevate precocemente nel sistema visivo, ma la differenziazione di lettere simili è il risultato di un processo più complesso ed avviene ai livelli superiori. Davis e Driver hanno usato figure delineate da contorni illusori basate sul triangolo di Kanizsa, e i loro risultati sono in accordo con un’analisi precoce delle caratteristiche da parte del sistema visivo. Pertanto, le prime aree visive possiedono il meccanismo neurale coinvolto nella definizione dei contorni.

A) Discriminare un pallino rosso in mezzo a tanti altri verdi è un compito che richiede poco sforzo attentivo. (B) Tuttavia risulta più difficile discriminare una L in mezzo a molte T.
Proprietà e organizzazione dei neuroni nella corteccia IT
Ma mano che si prosegue lungo le aree corticali della scimmia deputate all’analisi degli oggetti (V1 V2 V4 IT posteriore (PIT) e IT anteriore (AIT)) le proprietà di risposta dei neuroni cambiano, il campo recettivo delle cellule s’ingrandisce considerevolmente. Ad es. V1 1 grado, V4 4 gradi, PIT 16 gradi, AIT 150 gradi. L’ingrandimento del campo recettivo permette lo sviluppo di una risposta visiva che non dipende dalla grandezza e dalla posizione dello stimolo nel campo visivo. La cellula, inoltre, può rispondere a stimoli più complessi. In V4 e PIT si è osservato che la maggior parte delle cellule è sensibile alle qualità primarie (colore, dimensione, orientamento) mentre AIT sembrano essere sensibili a forme e configurazioni complesse.
Le modalità con cui le cellule IT codificano gli oggetti appare complesso:
Tanaka ha deciso di determinare le caratteristiche minime necessarie a eccitare una cellula in AIT. La procedura inizia presentando un elevato numero di oggetti mentre si registra la sua risposta, al fine d’individuare l’oggetto che la eccita. A questo punto le sue componenti caratteristiche sono separate e presentate singolarmente o in combinazione. Llo scopo è trovare la più semplice combinazione di caratteristiche a cui la cellula risponde in modo ottimale. Il problema risiede nella difficoltà a presentare tutte le possibili combinazioni di caratteristiche, poiché anche lo stimolo più semplice possederà caratteristiche elementari come profondità, colore, forma, etc.
Tanaka ha osservato una popolazioni di neuroni IT dette cellule elaborate che sembrano rispondere a forme semplici, inoltre ha ipotizzato che cellule strettamente adiacenti generalmente rispondono a configurazioni di caratteristiche simile. Attraverso registrazioni con penetrazioni verticali egli ha osservato che le cellule rispondono allo stesso stimolo ottimale. Questi risultati suggeriscono che le cellule in IT sono organizzate in colonne funzionali o moduli, in maniera simile all’organizzazione di V1.
L’alfabeto visivo: la teoria dei geoni di Biederman
Questo ha dato origine all’idea che le forme semplici formano un alfabeto visivo da cui possa essere costruita la rappresentazione dell’oggetto. Sulla base delle risposte delle cellule elaborate, una rappresentazione potrebbe essere ottenuta in almeno due modi: uno, attraverso una gerarchia in cui cellule elaborate invierebbero un segnale alle cellule dei livelli successivi. Successivamente, l’informazione in uscita da quest’ultime segnalerebbe la presenza di un oggetto complesso alle aree superiori come la corteccia prefrontale. Potrebbero non esserci livelli successivi: l’insieme di risposte fornite dalle varie colonne di cellule elaborate potrebbero direttamente segnalare la presenza di un oggetto complesso a un’area superiore senza dover convergere su una cellula dell’area IT.
Il concetto di alfabeto visivo assume quindi che una cellula IT segnali in modo affidabile la presenza di una particolare forma semplice che la eccita, e quindi un oggetto complesso che comprende questa forma semplice dovrebbe evocare una forte risposta, ma invece non è così; la presenza di altre caratteristiche può conpromettere la risposta della cellula al suo stimolo ottimale.
Biederman ha proposto una teoria del riconoscimento basata sulla scomposizione di oggetti complessi in forme componenti semplici.
Biederman considera un ristretto insieme di forme basilari come cunei e cilindri che ha denominato geoni. Queste descrizioni qualitative potrebbero essere sufficienti a distinguere differenti classi di oggetti, ma non a discriminare all’interno di una classe di oggetti aventi le stesse componenti basi. Inoltre, questo modello è inadeguato a differenziare forme dissimili in cui le similarità percettive delle forme possono indurre a riconoscere simili tra loro oggetti che invece sono composti da geoni diversi.
Oggetti complessi in tre dimensioni
Sin dai primi anni 70 è nota l’esistenza di neuroni, nella corteccia visiva temporale della scimmia, che rispondono alle facce, alle mani e ad altri stimoli biologici complessi. Le cellule selettive per i volti sono localizzate in IT, sui bordi e sulle pareti di STS. Lo stimolo ottimale di una larga proporzione di queste cellule non può essere decomposto in forme più semplici.
In generale le cellule che rispondono alle facce non manifestano alcuna risposta a qualsiasi altro tipo di stimolo presentato, ma rispondono fortemente a una varietà di facce, comprese modelli di plastica, immagini video, e disegni. Le risposte di queste cellule sono indipendenti dalle dimensioni e dalla posizione dello stimolo.
In giallo è stato evidenziato il giro-inferotemporale. Area cerebrale implicata nella dicriminazione delle facce.Il giro inferotemporale (IT) è un’area del lobo temporale del cervello che ha attirato l’attenzione dei neuroscienziati per il suo ruolo di primo piano nel processamento visivo e, in particolare, nel riconoscimento degli oggetti

Le cellule per le facce
Le cellule per le facce sono sensibili alla posizione relativa delle caratteristiche all’interno della faccia, in particolare alla distanza tra gli occhi, tra gli occhi e la bocca, la quantità di capelli. Inoltre, la presentazione di una singola frazione facciale evoca solo una frazione di risposta, e la rimozione di una singola componente riduce ma non elimina la risposta della cellula per il volto.
Queste cellule continuano anche a rispondere a immagini di facce sottoposte ad un filtraggio passa-basso o passa-alto, o che abbiano subito l’alterazione del colore o del contrasto. Queste complesse proprietà neuronali suggeriscono che tale classe di cellule sia davvero selettiva per le facce.
La maggior parte delle cellule in AIT e in STS è selettiva per l’angolo di presentazione del volto. Queste cellule sono definite dipendenti dall’angolo di visualizzazione, o centrate sull’osservatore.
Le cellule indipendenti dall’angolo di presentazione dello stimolo, o centrate sull’oggetto, potrebbero derivare dalla combinazione delle risposte di diverse cellule angolo dipendenti. Questo schema gerarchico suggerisce che la latenza di risposte delle cellule angolo indipendenti debba essere più lunga di quella delle cellule angolo dipendenti. Inoltre, studi di registrazione di singole cellule suggeriscono che le cellule sensibili alle facce, come le cellule elaborate abbiano un’organizzazione colonnare.
La cellula della nonna
Le cellule del lobo temporale, selettive alle facce, somigliano superficialmente alle unità gnostiche proposte da Konorski, o alle cellule cardinali proposte da Barlow. Tali cellule sono descritte come unità all’apice della piramide dell’elaborazione visiva. Alla base si troverebbero i rilevatori di linee e bordi nella corteccia striata, successivamente i rilevatori di complessità crescente fino alle ’unità che rappresentono uno specifico oggetto o persona.
Questa ipotesi però presenta seri problemi: infatti, il numero degli oggetti in cui c’imbattiamo durante la nostra vita è enorme, forse molto più grande del numero di neuroni di cui disponiamo, perciò questo metodo di codifica è del tutto inefficiente, poiché ci sarebbe bisogno di un vasto numero di cellule inutilizzate tenute in riserva per codificare nuovi oggetti.
Le cellule selettive per le facce, come le altre cellule IT probabilmente formano una rete distribuita per la codifica delle caratteristiche generali degli oggetti. Le facce sono quindi decodificate dall’attività combinata di popolazioni o insiemi di cellule. questo tipo di codifica permette di far fronte agli svantaggi della teoria della cellula della nonna. Infatti, il numero di facce, o oggetti specifici, codificate da una popolazione di cellule può essere molto più grande del numero di cellule che costituiscono la popolazione, inoltre non è necessaria alcuna riserva di cellule non utilizzata.
Se la popolazione risponde a un grande numero di facce, questa deve essere grande; essa è denominata codifica distribuita. Se una cellula risponde solo a un piccolo numero di facce specifiche, allora solo un esiguo numero di cellule nella popolazione sarà necessario a distinguere un particolare volto; ciò va sotto il nome di codifica limitata. Gli esperimenti di registrazione di singole cellule nell’area IT di scimmia hanno dimostrato che i neuroni sensibili alle facce sono estremamente selettivi e quindi sono in accordo con la codifica limitata.
Integrare le conoscenze sul riconoscimento dei volti
Il riconoscimento dei volti è un processo affascinante e complesso che ha da sempre incuriosito neuroscienziati e psicologi. Cerchiamo di integrare le diverse informazioni presentate per costruire una visione più completa di questo fenomeno.
Il mito della “cellula della nonna” e la realtà delle reti neurali
Il concetto di “cellula della nonna”, ovvero l’idea che esista un singolo neurone dedicato al riconoscimento di una persona specifica, è stato affascinante ma si è rivelato eccessivamente semplicistico. La ricerca ha mostrato che il riconoscimento dei volti è un processo distribuito, coinvolgente vaste reti neurali.
- Reti distribuite: Diverse aree del cervello lavorano in sinergia per codificare le informazioni relative ai volti. Non esiste un’unica “cellula della nonna”, ma piuttosto un’elaborazione parallela e distribuita di caratteristiche come la forma del viso, gli occhi, il naso e la bocca.
- Processi gerarchici: L’elaborazione visiva dei volti segue una gerarchia: da caratteristiche semplici (linee, curve) a rappresentazioni più complesse (volti interi).
- Plasticità: Le reti neurali coinvolte nel riconoscimento dei volti sono plastiche, cioè si modificano in base all’esperienza. Questo spiega perché diventiamo sempre più bravi a riconoscere i volti delle persone che frequentiamo.
Le sfide del riconoscimento dei volti
Il riconoscimento dei volti presenta diverse sfide:
- Variabilità: I volti presentano una grande variabilità dovuta a fattori come l’espressione, l’illuminazione, l’età e l’angolazione.
- Numero infinito di volti: Il numero potenziale di volti da riconoscere è praticamente infinito, rendendo impraticabile l’idea di avere un neurone dedicato per ogni volto.
- Occlusioni: Spesso i volti sono parzialmente occlusi da oggetti o altre persone, rendendo il riconoscimento più difficile.
- Illusioni: Il nostro sistema visivo può essere ingannato da illusioni ottiche che alterano la percezione dei volti.
Modelli teorici
Per spiegare il riconoscimento dei volti sono stati proposti diversi modelli:
Modelli basati su template: Questi modelli confrontano l’immagine del volto con una serie di template pre-immagazzinati. Tuttavia, il numero elevato di possibili variazioni dei volti rende questo approccio poco pratico.
Modelli strutturali: Questi modelli si basano sull’idea che i volti sono composti da parti (occhi, naso, bocca) e che le relazioni spaziali tra queste parti sono cruciali per il riconoscimento.
Modelli basati su reti neurali: I modelli ispirati al funzionamento del cervello utilizzano reti neurali artificiali per apprendere le caratteristiche distintive dei volti. Questi modelli sono in grado di generalizzare e di adattarsi a nuove situazioni.
L’attenzione visiva e la memoria
I processi pre-attentivi, attentivi e la segregazione figura sfondo
La capacità d’immagazzinare e codificare pienamente gli oggetti in memoria da parte dei neuroni è limitata. Desimone ha suggerito che gli oggetti debbano competere per l’attenzione e lo spazio di codifica nel sistema visivo, e che questa competizione può essere influenzata sia da fattori cognitivi sia da fattori automatici.
I fattori automatici sono descritti come processi pre-attentivi (boottom-up), mentre per fattori cognitivi s’intende i processi attentivi (top-down), I fattori preattentivi sono coinvolti con le proprietà intrinseche dello stimolo di una scena, così gli stimoli che differiscono dal loro sfondo avranno il vantaggio competitivo di occupare l’attenzione del sistema visivo e acquisire spazio di codifica.
La separazione di uno stimolo dal suo sfondo è detta segregazione figura-sfondo. I processi attentivi possono imporsi sui processi pre-attentivi. Questo meccanismo sembra funzionare a livello delle singole cellule: quando una scimmia presta attenzione ad uno stimolo le registrazioni mostrano una soppressione delle risposte delle cellule in IT allo stimolo ignorato.
Processi analoghi sembrano verificarsi nella memoria visiva a breve termine. Una precedente presentazione di stimoli visivi può avere un effetto di soppressione o miglioramento della risposta neuronale. Ripetute presentazioni di uno stimolo riducono le risposte dei neuroni in IT allo stesso stimolo. Ciò suggerisce che si tratta di un processo automatico che agisce come meccanismo di figura sfondo.
L’aumento di scarica dei neuroni dell’area IT nei compiti attentivi associati alla memoria a breve termine
L’aumento di attività neuronale si verifica solo quando la scimmia svolge attivamente un compito di memoria a breve termine come un compito di associazione ritardata in cui gli animali devono identificare uno stimolo presentato on precedenza.
Alcuni neuroni nell’area IT della scimmia mantengono un’elevata frequenza di scarica durante l’intervallo di ritenzione: questa attività potrebbe essere un aiuto alla formazione della memoria a breve termine (che secondo Desimone avviene per un processo top down). Come i neuroni IT, alcuni neuroni nella corteccia prefrontale laterale conservano un’elevata frequenza di risposta durante l’intervallo di ritenzione. Questo mantenimento della scarica è temporaneamente interrotto da stimoli addizionali durante l’intervallo di ritenzione, ma l’attività riprende rapidamente.
I processi di memoria pre attentivi sono sensibili alla ripetizione dello stimolo e automaticamente influenzano i processi visivi verso stimoli nuovi e poco frequenti. I processi attentivi sono importanti quando cerchiamo uno stimolo particolare .
Aree coinvolte nella nella rievocazione di immagini visive dalla memoria a lungo termine
Sebbene si pensi che la memoria a lungo termine sia mediata prevalentemente dall’ippocampo e dalle aree associative, tutte queste hanno estese proiezioni dirette ed indirette verso il sistema visivo. Studi con PET e fMRI hanno mostrato che nella rievocazione degli oggetti, le aree visive superiori sono attive e che lesioni a queste aree danneggiano il processo di rievocazione. C’è stato però un dibattito sulla possibile attivazione delle prime aree visive V1 e V2. Al momento sembra che tutte le aree visive corticali siano attive durante le immagini mentali e nella rievocazione di immagini visive dalla memoria a lungo termine.